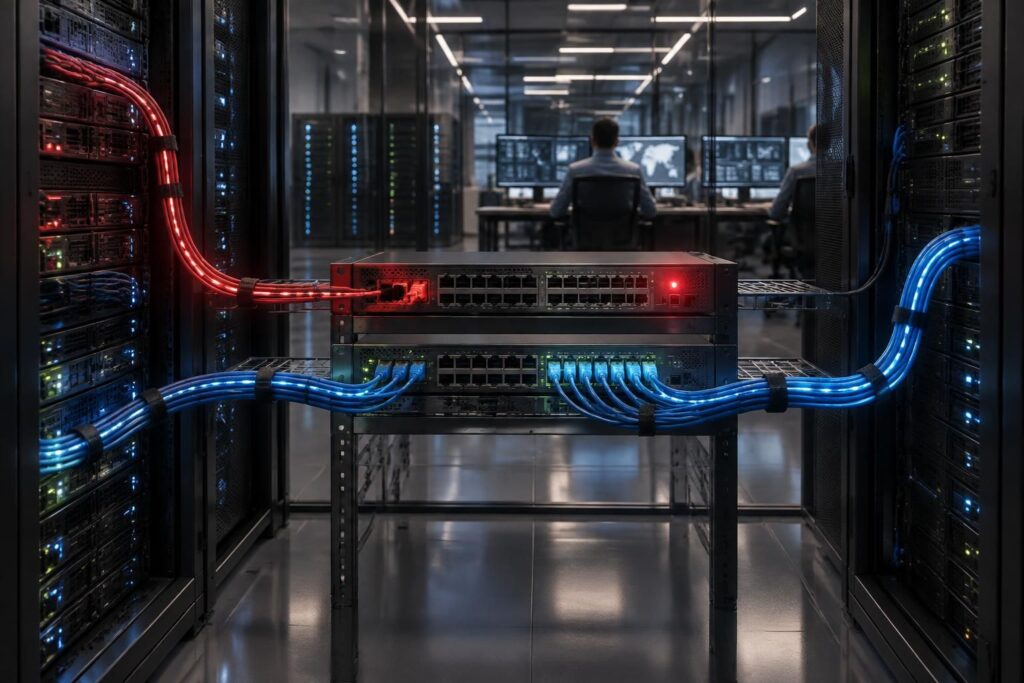
Une panne de réseau peut interrompre les ventes, bloquer les outils métier ou isoler un site. Le fail over — ou basculement automatique — permet à une ressource de secours de prendre le relais. Comprendre ses mécanismes aide à concevoir une infrastructure capable de maintenir la continuité de service, sans confondre redondance et haute disponibilité.
L’article en bref
Le fail over prépare le réseau à poursuivre son activité lorsqu’un équipement ou une liaison rencontre un problème. Ses bénéfices dépendent autant du choix de l’architecture que de tests réguliers et d’une supervision adaptée.
- Le principe : Une ressource de secours prend le relais après détection d’une défaillance.
- Les architectures : Les modes actif/passif et actif/actif répondent à des besoins différents.
- Les prérequis : Diversifier les liens et éliminer les points uniques de défaillance.
- La fiabilité : Tester les bascules et surveiller les performances pour limiter les interruptions.
Une stratégie de fail over efficace se conçoit, se teste et s’ajuste aux besoins réels de l’activité.
Fail over : le principe du basculement automatique
Le fail over, ou basculement, désigne le passage d’un équipement ou d’un service vers une ressource alternative lorsqu’une défaillance est détectée. Selon l’architecture, le relais peut être assuré par un serveur de secours, un routeur, un pare-feu ou une liaison réseau secondaire.
Dans une entreprise fictive comme Atelier Nord, une coupure de la connexion principale ne devrait pas empêcher les équipes d’accéder aux applications métier. Si une seconde liaison est configurée et correctement supervisée, le trafic peut être redirigé vers elle sans intervention immédiate. La continuité de service dépend toutefois du temps de détection, du délai de bascule et de la capacité du lien de secours.
Le basculement est souvent automatique et discret pour les utilisateurs, mais ce n’est pas systématique. Pour certaines opérations sensibles, une validation humaine peut être préférable : automatiser n’implique pas de supprimer tout contrôle.
Redondance réseau, fail over et haute disponibilité : quelles différences ?
Ces notions se complètent, mais ne décrivent pas la même chose. La redondance réseau consiste à prévoir plusieurs composants ou chemins ; le fail over est le mécanisme qui exploite cette alternative ; la haute disponibilité désigne l’objectif global de maintien du service.
Une infrastructure peut donc comporter deux routeurs sans être réellement résiliente : si les deux dépendent de la même alimentation ou du même câble physique, un incident commun peut les rendre indisponibles. La tolérance aux pannes se construit en examinant toute la chaîne, des accès opérateurs jusqu’aux équipements et à l’énergie.
| Notion | Rôle | Exemple |
|---|---|---|
| Redondance | Prévoir une alternative à un composant critique. | Deux accès Internet empruntant des chemins distincts. |
| Fail over | Détecter une panne et transférer le service. | Le trafic passe sur le second accès. |
| Haute disponibilité | Viser un service accessible malgré les incidents. | Les applications restent utilisables pendant la bascule. |
Pour évaluer le résultat, les équipes peuvent suivre le MTTR, soit le temps moyen de réparation, ainsi que le RTO, la durée maximale d’interruption acceptable. Le RPO, lui, exprime la quantité maximale de données qu’une organisation accepte de perdre : il dépend notamment de la fréquence de réplication des données et des mécanismes de sauvegarde.
Actif/passif ou actif/actif : choisir une architecture de fail over
Le mode actif/passif, un relais simple à comprendre
Dans une configuration actif/passif, une ressource principale gère le trafic tandis qu’une autre reste en attente. Si la première devient indisponible, le système déclenche le basculement vers le composant secondaire. Ce modèle est fréquent lorsqu’une entreprise souhaite disposer d’un lien de secours sans répartir la charge en temps normal.
Son intérêt tient à sa lisibilité et à une mise en œuvre souvent plus simple. En revanche, la capacité de secours reste peu utilisée tant qu’aucun incident ne survient, et la bascule peut entraîner une brève interruption. Pour Atelier Nord, un accès cellulaire réservé aux urgences peut compléter la fibre principale, à condition d’être testé et suffisamment dimensionné.
Le mode actif/actif, pour utiliser plusieurs ressources
En actif/actif, plusieurs liens ou serveurs traitent simultanément les demandes. L’équilibrage de charge répartit le trafic selon des règles définies ; si une ressource tombe, les autres absorbent une partie de son activité. Cette approche exploite mieux les capacités disponibles, mais demande une configuration plus précise.
Le dimensionnement reste déterminant : si chaque lien fonctionne presque à pleine capacité, la perte de l’un d’eux peut saturer les ressources restantes. Une architecture active/active n’est donc pas automatiquement plus résiliente ; elle doit conserver une marge suffisante pour les scénarios dégradés.
- Actif/passif : privilégier la simplicité et un relais clairement identifié.
- Actif/actif : répartir la charge et prévoir une capacité suffisante après incident.
- Multi-WAN : combiner des accès différents pour réduire les risques de panne commune.
Le bon choix dépend des applications, du niveau d’interruption acceptable et du budget consacré aux liens et équipements.
Protocoles et outils pour assurer le basculement de liaison
Le mécanisme de bascule peut s’appuyer sur des protocoles réseau, des contrôles de disponibilité ou une solution SD-WAN. VRRP permet à plusieurs routeurs de partager une adresse IP virtuelle : si le routeur actif ne répond plus, un autre peut reprendre ce rôle. HSRP offre une fonction comparable dans les environnements Cisco.
Pour des connexions Internet multiples, BGP peut annoncer des routes par différents opérateurs. Des sondes de supervision peuvent également vérifier non seulement qu’une liaison est active, mais aussi que sa qualité reste suffisante. La mesure de la latence, de la perte de paquets ou de la gigue aide à déclencher un basculement de liaison avant une coupure complète.
Le SD-WAN ajoute une gestion plus fine du trafic : certaines solutions peuvent rediriger uniquement les applications touchées par une dégradation, plutôt que de déplacer tous les flux. La réplication des données, de son côté, répond à un autre besoin : protéger l’accès aux informations et faciliter leur restauration si un serveur ou un site devient indisponible.
Construire une stratégie de fail over adaptée à l’entreprise
Une architecture robuste commence par l’identification des points uniques de défaillance. Deux accès souscrits auprès d’opérateurs différents ne garantissent pas toujours une diversité physique : ils peuvent partager une partie du même tracé. Il faut aussi examiner les routeurs, les commutateurs, l’alimentation électrique et les équipements situés dans les locaux.
La connectivité 4G ou 5G peut servir de lien de secours, car elle ne dépend pas de la boucle locale filaire. Elle apporte une solution utile en cas de coupure de fibre, mais sa bande passante et sa latence varient selon la couverture et la charge du réseau. Les usages critiques et les volumes de données doivent être évalués avant de s’y fier pour une longue durée.
Pour structurer le travail, une équipe réseau peut suivre ces étapes :
- Cartographier les dépendances : repérer les équipements, applications et chemins réseau indispensables.
- Fixer des objectifs : préciser les durées d’interruption et les pertes de données acceptables.
- Choisir les ressources de secours : diversifier opérateurs, technologies et parcours physiques.
- Configurer la détection : définir les seuils de panne ou de dégradation qui déclenchent la bascule.
- Tester et documenter : mesurer le résultat, vérifier les applications et actualiser les procédures.
Les engagements des fournisseurs, comme les délais d’intervention ou de rétablissement, complètent le dispositif, sans remplacer les tests internes. Une bascule qui n’a jamais été éprouvée reste une hypothèse, pas une garantie.
Tester la reprise après incident et éviter les mauvaises surprises
La reprise après incident ne se limite pas au retour de la connexion. Certaines sessions peuvent être interrompues, des applications nécessiter une reconnexion ou des données devoir être vérifiées. Un test utile simule la perte d’un lien, observe le comportement des services, puis mesure le temps nécessaire pour retrouver un fonctionnement normal.
Atelier Nord peut, par exemple, planifier une coupure contrôlée de son accès principal en dehors des périodes de forte activité. L’équipe vérifie alors que les postes accèdent toujours aux outils, que les appels passent par la liaison alternative et que les alertes parviennent aux personnes concernées. Après le test, les écarts servent à ajuster la configuration.
Le retour à l’architecture initiale, appelé failback, mérite lui aussi une procédure. Il peut être automatique ou manuel ; dans les deux cas, il faut éviter un retour prématuré vers une liaison encore instable. Des tests périodiques et une supervision continue transforment ainsi un dispositif technique en capacité opérationnelle.
Questions fréquentes sur le fail over
Le fail over est-il toujours automatique ?
Non. Le basculement peut être déclenché automatiquement par une supervision ou demander une validation humaine, notamment lorsque l’impact d’une décision automatique doit être contrôlé.
Quelle différence entre fail over et sauvegarde ?
Le fail over transfère un service vers une ressource disponible. Une sauvegarde conserve une copie des données pour les restaurer après une perte ou une altération ; les deux dispositifs sont complémentaires.
Un lien 4G ou 5G suffit-il comme secours ?
Il peut fournir une connectivité alternative, indépendante de l’accès filaire local. Sa couverture, son débit, sa latence et son enveloppe de données doivent toutefois être adaptés aux usages de l’entreprise.
À quelle fréquence tester un dispositif de fail over ?
La fréquence dépend de la criticité des services et des changements apportés à l’infrastructure. Des tests planifiés, après une modification importante et selon les procédures internes permettent de vérifier que la bascule et le retour fonctionnent comme prévu.
Je suis Léa Marchand, rédactrice spécialisée en formation et compétences numériques. J’aide celles et ceux qui veulent apprendre à coder, se reconvertir ou faire grandir leur carrière à décrypter les bons parcours, les financements et les métiers de la tech. J’écris clair, sans jargon, avec des méthodes qui marchent.